

Wdrażasz nową stronę w piątek, klientowi podoba się projekt, a po dwóch tygodniach strony głównej dalej nie ma w Google. noindex ze środowiska testowego poszedł na produkcję razem z resztą, a po przepięciu domeny nikt nie zajrzał do źródła strony.
W listopadzie 2026 przepuściłem przez skrypt 100 popularnych stron głównych i prawie jedna trzecia z nich nadal miała problem, który checklista startu powinna była złapać. Niżej jest lista, którą przechodzę przy każdej nowej stronie, w dwóch rundach, z darmowym sposobem sprawdzenia każdego punktu i protokołem przekazania dla klienta. Dane i skrypty są w pakiecie badania.
Co obejmuje checklista odbioru strony internetowej
Checklista odbioru strony internetowej to lista technicznych sprawdzeń, które robisz na nowej stronie dwa razy, raz na produkcji przed przepięciem domeny i raz zaraz po starcie. Od niej zależy, czy roboty dotrą do twojej strony i czy odwiedzający nie trafią na błędy w podstawach, a kończy się przekazaniem strony klientowi.
Ten poradnik dotyczy zupełnie nowej strony. Przeniesienie istniejącej strony na nowe adresy wymaga mapy przekierowań dla każdego starego adresu, więc dostaje osobną checklistę migracji. A jeśli potrzebujesz dokumentu, który wysyłasz po pełnym przeglądzie, rozpisałem to w poradniku o tym, jak przygotować raport z audytu strony dla klienta.
Prawie co trzecia popularna strona główna ma pozostałość po starcie
Dla każdej domeny pobrałem stronę główną, robots.txt, sitemapę, favicon, jeden wymyślony adres i wersję http://. 27 na 100 miało co najmniej jeden prawdziwy problem inny niż favicon, a kolejne cztery trafiły na listę tylko przez brak favicona. Część serwerów nie oddaje ikon botom, więc łączne 31 traktuj jako górną granicę. Najczęstszy to wymyślony adres z odpowiedzią 200, czyli strona zgłaszała sukces dla czegoś, czego nie ma, a połowa tych stron robiła to przekierowaniem na stronę główną.
Poważne pozostałości były rzadkie. Jedna strona główna miała noindex, a jeden robots.txt blokował Googlebotowi całą stronę, i każda z tych rzeczy wystarczy, żeby strony nie było w Google. Nie znalazłem ani jednej strony głównej z linkiem do hosta testowego albo z canonicalem na niego. To dobra wiadomość dla stron, które działają od lat, ale w dniu startu te pozostałości są najświeższe, więc zostają na mojej liście.
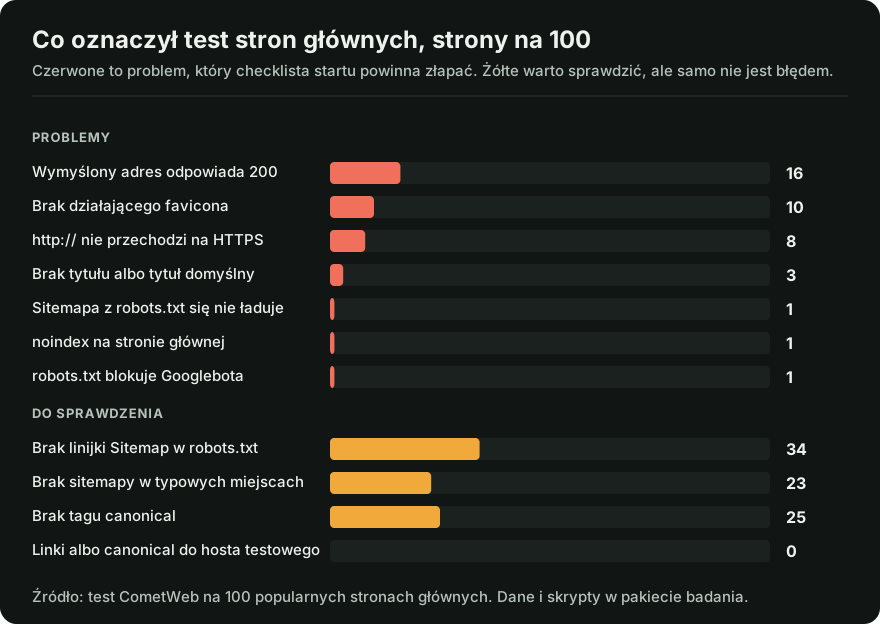
Brak linijki Sitemap jest w grupie „Do sprawdzenia”, bo sitemapę można zgłosić w Search Console. Mój pierwszy przebieg miesiąc wcześniej liczył go jako błąd i podbił wynik prawie do połowy, więc go przeniosłem i teraz liczę tylko rzeczy, które same w sobie są złe.
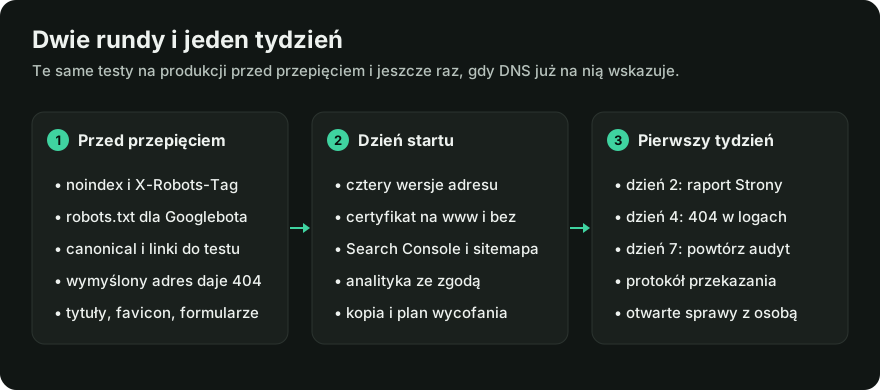
Checklista przed startem strony: indeksowanie i crawl
Runda przed startem sprawdza, czy wyszukiwarki mogą znaleźć i zindeksować twoją nową stronę. Rób ją na produkcji, bo środowisko testowe jest celowo zamknięte, a te blokady jadą razem z kodem. Do serwera produkcyjnego dostaniesz się przez wpis w pliku hosts albo tymczasowy adres, zanim domena zacznie na niego wskazywać.
- ☑ Publiczne strony nie mają
noindex. Otwórz źródło strony, wyszukajnoindex, a potem sprawdź nagłówki odpowiedzi w DevTools > Network pod kątemX-Robots-Tag. Dokumentacja Google o blokowaniu indeksowania opisuje oba miejsca. - ☑ robots.txt wpuszcza Googlebota. Przeczytaj grupę, która dotyczy Googlebota, bo grupa napisana dla niego ma pierwszeństwo przed grupą
*. Dwie strony z mojej próby blokowały wszystkie boty w grupie*, a Googlebota wpuszczały osobną grupą. Klasyka toDisallow: /zostawione z testów, a nasz tester robots.txt przeczyta plik za ciebie. - ☑ Tag canonical wskazuje adres produkcyjny. Powinien być pełnym adresem na docelowym hoście, na
https://, bez domeny testowej i bez starego adresu podglądu. - ☑ W szablonach nie zostały linki do testu. Przeszukaj źródło strony pod kątem hosta testowego i
localhost, bo adresy wpisane na sztywno w menu i formularzach łatwo przeżywają start. - ☑ Jeśli masz sitemapę, ładuje się i zawiera strony do indeksowania. Wpisz ją linijką
Sitemap:w robots.txt albo zgłoś w Search Console, tak jak opisuje to poradnik Google o tworzeniu sitemapy. - ☑ Środowisko testowe stoi za hasłem, więc nie konkuruje z prawdziwą stroną w wynikach, gdy obie są publiczne.
Jedna pułapka łapie tych, którzy chcą być ostrożni. Jeśli zablokujesz stronę w robots.txt i dodatkowo dasz noindex, Google nigdy nie zobaczy noindex, bo nie może pobrać strony. Używaj noindex do trzymania strony poza indeksem, a robots.txt do tego, żeby roboty nie traciły czasu na zbędne adresy.
Sygnały, które o sobie nie wiedzą, złapały też mnie, bo sitemapa cometweb.io dalej zgłaszała osiem wpisów ukrytych z listy bloga. O tym, jak się kłócą, piszę w poradniku canonical, sitemapa i robots.txt.
Checklista QA strony: błędy, tytuły i to, co widzi odwiedzający
Runda QA to wciąż pierwsza runda, na produkcji przed przepięciem. Obejmuje to, co widzą odwiedzający i roboty, gdy coś pójdzie lekko nie tak, na przykład literówka w adresie albo formularz wysyłający w próżnię. To drobiazgi, ale twój klient zauważy je pierwszego dnia.
- ☑ Brakująca strona zwraca 404. Wpisz
twojadomena.pl/tej-strony-nie-mai sprawdź kod w DevTools > Network. Strona błędu może być przyjazna, ale serwer powinien odpowiedzieć 404, a przy treści usuniętej celowo 410. - ☑ Każdy typ strony ma własny tytuł. Wytyczne Google dotyczące linków tytułowych wymieniają „Home” jako mało mówiący tytuł strony głównej. Sprawdź po jednej stronie z każdego szablonu, na przykład wpis i produkt.
- ☑ Favicon się ładuje. Google pokazuje favicon w wynikach wyszukiwania i chce, żeby był podlinkowany ze strony głównej. Generator faviconów przygotuje pliki, ale wdrożony link i tak sprawdzasz sam.
- ☑ Formularze wysyłają na prawdziwą skrzynkę. Wypełnij każdy formularz raz i sprawdź, czy wiadomość trafia tam, gdzie spodziewa się jej twój klient, razem z automatyczną odpowiedzią.
- ☑ Podstawy działają na telefonie i z klawiatury. Otwórz menu na prawdziwym telefonie, a potem przejdź klawiszem Tab przez stronę główną i formularz kontaktowy.
- ☑ Panel administracyjny jest zamknięty, a tryb debugowania wyłączony. Usuń konta testowe i domyślne loginy, włącz logowanie dwuskładnikowe i sprawdź, czy strona błędu nie pokazuje ścieżek z serwera.
Dlaczego punkt z 404 jest ważny na nowej stronie? Przy przekierowaniu wszystkiego na stronę główną stare linki i skasowane strony testowe lądują na niej z kodem 200, więc nigdy się nie dowiesz, że są zepsute. Google nazywa to soft 404, czyli stroną błędu podaną z kodem sukcesu.
Tak odróżnisz te przypadki.
| Żądanie | Dobra odpowiedź | Zła odpowiedź |
|---|---|---|
| Strona, która nigdy nie istniała | 404 z pomocną stroną | 200 ze stroną główną |
| Strona usunięta na stałe, bez zamiennika | 404 albo 410 | 301 na stronę główną |
| Stary adres z jasnym zamiennikiem | 301 na zamiennik | 404, choć zamiennik istnieje |
Checklista startu strony: HTTPS, przekierowania i analityka w dniu startu
Rundę startową robisz, gdy DNS wskazuje już produkcję, a potem powtarzasz ją kilka godzin później. Pamięć podręczna DNS odświeża się w różnym tempie, więc część odwiedzających przez jakiś czas trafia na stary serwer.
- Sprawdź wszystkie cztery wersje adresu. Wpisz
http://,http://www.,https://ihttps://www.i sprawdź, czy twój adres kanoniczny ładuje się od razu, a pozostałe trzy trafiają do niego przekierowaniem stałym. Tester przekierowań pokaże każdy krok, a docelowo ma być jeden, o czym piszę przy łańcuchach przekierowań. - Potwierdź, że certyfikat obejmuje
wwwi domenę bezwww, bo certyfikat tylko na jedną z nich psuje przekierowanie z drugiej, zanim w ogóle ruszy. - Zweryfikuj stronę w Google Search Console i zgłoś sitemapę. Strona pomocy Google o weryfikacji własności wymienia metody, a ja wolę weryfikację przez DNS, bo przeżywa zmianę szablonu.
- Przetestuj analitykę z banerem zgody. W jednej świeżej sesji zaakceptuj, w drugiej odrzuć, a potem obejrzyj aktywność tagów w DevTools i w GA4 DebugView. Jedno wyświetlenie strony powinno wysłać się raz, więc szukaj zdublowanych tagów.
- Zrób kopię zapasową i zapisz, jak wycofać zmiany. Jeśli start podmienia coś na istniejącej domenie, skopiuj starą stronę z bazą i sprawdź, że kopia się odtwarza, a TTL rekordów DNS obniż dzień wcześniej, żeby powrót nie trwał godzinami. Zanotuj, która wersja jest na produkcji i kto może ją cofnąć, bo poprawka w dniu startu idzie spokojniej, gdy droga powrotu jest znana.
Osiem stron głównych z mojej próby odpowiadało pod zwykłym http:// bez przekierowania na HTTPS, choć HTTPS działał na każdej z nich. Naprawa to zwykle jedna reguła przekierowania na serwerze albo w CDN. Zanim ją dodasz, sprawdź certyfikat, bo przekierowanie na host bez ważnego certyfikatu zamienia cichy problem na głośny.
Dane strukturalne, mixed content i podgląd linku
Te trzy rzeczy rzadko psują sam start, za to wychodzą tydzień później, gdy ktoś udostępni link albo Search Console zgłosi błąd. Sprawdzam je razem z rundą startową, bo każda zajmuje chwilę.
- ☑ Dane strukturalne przechodzą test. Przepuść stronę główną, jedną stronę usługi albo produktu i jeden wpis przez Test wyników z elementami rozszerzonymi, a jeśli stara strona miała schema, sprawdź, czy przeszła na nową.
- ☑ Nic nie ładuje się przez
http://. W DevTools > Console poszukaj ostrzeżeń o mieszanej treści, które zwykle zostawiają obrazki wklejone w treść przed włączeniem HTTPS. - ☑ Kluczowe strony mają tagi Open Graph. Bez
og:title,og:descriptioniog:imagez protokołu Open Graph link wklejony na LinkedInie pokaże przypadkowy obrazek i tytuł.
Pierwszy tydzień po starcie nowej strony
W pierwszym tygodniu trzymam się prostego rytmu dnia 2, dnia 4 i dnia 7. Ustal go z klientem z góry, bo to twój harmonogram przeglądu i nie ma nic wspólnego z tempem Google.
- Dzień 2: otwórz Search Console > Indeksowanie > Strony oraz Mapy witryn i zapisz, czy Google przeczytał już twoją sitemapę. Nowa strona potrzebuje czasu, więc zapisz stan bez paniki.
- Dzień 4: poszukaj błędów 404 w logach serwera i w Search Console. Przekieruj stary adres, gdy ma trafny zamiennik, a prawdziwe 404 zostaw, gdy go nie ma.
- Dzień 7: puść audyt, który robiłeś przed startem, z tymi samymi ustawieniami, i porównaj oba wyniki.
Audyt z dnia 7 zrobiłbym w CometWeb Insight, naszej aplikacji do audytu stron. Sprawdza wydajność, SEO, dostępność, bezpieczeństwo i CO₂e i układa znaleziska w sekcji „Co naprawić najpierw”. Porównasz w nim dwa przebiegi z tymi samymi ustawieniami, zobaczysz, co zmienił dzień startu, i wyeksportujesz wyniki do raportu PDF dla klienta.
Jak przekazać nową stronę klientowi
Przekazanie strony to moment, w którym klient bierze za nią odpowiedzialność, więc daj mu jednostronicowy protokół z trzech części.
- Co sprawdziliśmy przed startem i po nim: adres, data, wynik i dowód przy każdym punkcie, na przykład zrzut ekranu. Ptaszka bez zapisanego wyniku nie liczę.
- Kto jest właścicielem którego konta: domena, hosting, Search Console i analityka, każde z wpisanym właścicielem i działającym dostępem, plus dostęp agencji w ramach umowy serwisowej.
- Co jest jeszcze otwarte: każdy punkt z osobą odpowiedzialną, terminem i warunkiem zamknięcia.
Sformułowania mają znaczenie, bo klienci powtarzają twoje słowa swoim szefom. Różnica wygląda tak.
- Źle: „Strona jest zaindeksowana i gotowa pod SEO”.
- Dobrze: „Publiczne strony pozwalają na crawl, sitemapa się ładuje i ma uzgodnione adresy, a Search Console pokazuje, że ją przeczytał. O indeksowaniu decyduje Google, a raport Strony sprawdzimy siódmego dnia”.
Protokół przekazania skopiujesz z pakietu badania.
Błędy, które psują start nowej strony
Zepsuty start zwykle zaczyna się od ustawienia, które było dobre na środowisku testowym i złe na produkcji. Na te trzy uważałbym najbardziej.
- Kopiowanie bazy z testu bez zmian. W WordPressie pole „Widoczność dla wyszukiwarek” w Ustawienia > Czytanie siedzi w bazie danych i jedzie razem z nią, więc sprawdzaj je po każdym imporcie.
- Adres testowy wpisany na sztywno. Canonicale i akcje formularzy zapisane pełnym adresem testu dalej tam wskazują po przepięciu. Google zaleca w poradniku o adresach kanonicznych pełne adresy w canonicalu, bo względne sprawiają kłopot, gdy wersja testowa trafi do crawla, więc używaj pełnych adresów produkcyjnych.
- Zostawienie starej domeny samej sobie. Jeśli klient miał wcześniej stronę, przypisz starym adresom trafne zamienniki, i w tym miejscu zaczyna się już checklista migracji.
Na koniec
Każdy punkt tej listy zajmuje minutę, a trudna część to przejście jej na produkcji po przepięciu, kiedy wszyscy myślą, że praca jest skończona.
Zanim więc przepniesz domenę, otwórz na serwerze produkcyjnym robots.txt, źródło strony i wymyślony adres. Po starcie wpisz wszystkie cztery wersje adresu i wyślij klientowi protokół przekazania z wynikami. Jeśli chcesz mieć audyt z dnia 7 i raport dla klienta w jednym miejscu, załóż darmowe konto w Insight.
Najczęściej zadawane pytania
Kiedy zacząć checklistę przed startem strony?
Kilka dni przed startem, na serwerze produkcyjnym, bo ustawienia indeksowania i przekierowania często różnią się między testem a produkcją.
Czy muszę zgłaszać sitemapę w Google Search Console?
Możesz ją zgłosić w Search Console albo wpisać linijką Sitemap w robots.txt i oba sposoby działają. Małe strony z dobrym linkowaniem wewnętrznym Google znajdzie i bez niej.
Czym checklista odbioru różni się od checklisty migracji?
Checklista odbioru jest dla nowej strony bez historii, więc skupia się na indeksowaniu i podstawach. Checklista migracji dokłada mapę przekierowań z każdego starego adresu i porównanie ruchu oraz pozycji przed przeniesieniem i po nim.
Kto powinien przejść checklistę QA strony, agencja czy klient?
Agencja, bo to ona ma dostęp do serwera i kodu. Klient dostaje protokół przekazania z wynikami i sprawdza punkty biznesowe, na przykład czy wiadomości z formularzy trafiają na właściwą skrzynkę.
Po jakim czasie nowa strona pojawi się w Google?
Nie ma stałego terminu. Strona Google o ponownym indeksowaniu mówi, że crawl może trwać od kilku dni do kilku tygodni. Sprawdzaj raport Strony i stan sitemapy, a jeśli po pierwszym tygodniu nic się nie ruszyło, użyj sprawdzania adresu URL dla strony głównej.
Czy przy zupełnie nowej stronie potrzebuję kopii zapasowej przed startem?
Tak, jeśli start podmienia cokolwiek na istniejącej domenie, nawet prosty landing. Kopia starej wersji i obniżony TTL rekordów DNS pozwalają wrócić w kilka minut, gdy w dniu startu coś pójdzie źle.
Źródła
- Google Search Central: blokowanie indeksowania za pomocą noindex. Gdzie może być
noindexi dlaczego robots.txt go ukrywa. - Google Search Central: wprowadzenie do robots.txt. Co kontroluje robots.txt, a czego nie.
- Google Search Central: tworzenie i przesyłanie sitemapy. Linijka Sitemap w robots.txt i zgłoszenie w Search Console.
- Google Search Central: łączenie zduplikowanych adresów URL. Pełne adresy w canonical i ostrzeżenie o stronie testowej.
- Google: jak kody stanu HTTP wpływają na roboty Google. 404, 410 i soft 404.
- Google Search Central: wpływ na linki tytułowe. Dlaczego „Home” to słaby tytuł strony głównej.
- Google Search Central: favicon w wynikach wyszukiwania. Wymagania dla favicona.
- Pomoc Search Console: weryfikacja własności witryny. Metody weryfikacji.
- Google Search Central: prośba o ponowne zindeksowanie. Crawl trwa od kilku dni do kilku tygodni.
- Pomoc Google Analytics: DebugView. Podgląd zdarzeń podczas testu.
- Google Search Central: informacje o sitemapach. Kiedy mała, dobrze podlinkowana strona obejdzie się bez sitemapy.
- Google: Test wyników z elementami rozszerzonymi. Sprawdzenie danych strukturalnych na żywej stronie.
- MDN: mieszana treść. Zasoby ładowane przez
http://na stronie z HTTPS. - The Open Graph protocol. Tagi
og:title,og:descriptioniog:image. - CometWeb: test startu na 100 popularnych stronach głównych. Wyniki dla każdej strony, skrypty i dane.
Ujawnienie: CometWeb Insight i darmowe narzędzia z /pl/tools to produkty CometWeb, wydawcy tego bloga.